证书明明自动续期成功了,线上却还是过期:一次"续了但没装上"的故障复盘
一次线上证书过期告警的复盘:ACME 续期任务正常跑完、新证书已落盘,但 nginx 加载的还是旧证书。记录症状、定位过程、根因和几条防止再犯的具体做法。
本文目录
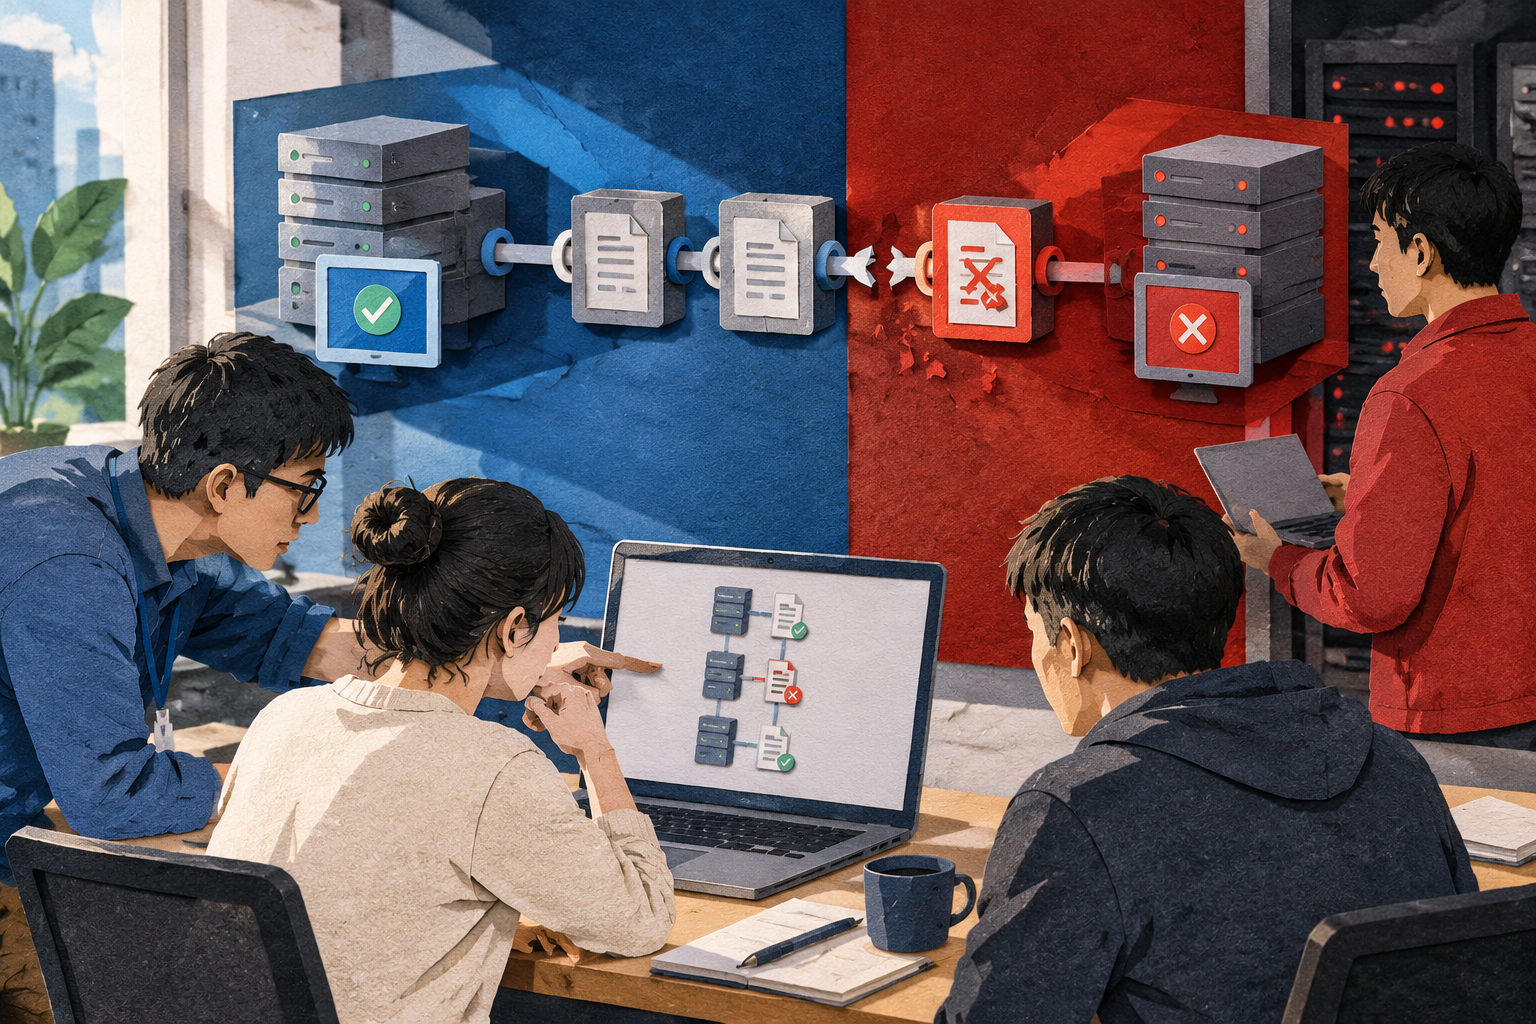
故障发生在凌晨两点四十几分,告警内容很直白:某域名证书剩余有效期不足一天,外部探测已经开始报 certificate has expired 的边缘情况。值班同事第一反应是"不可能,自动续期一直开着"。登录机器一看,/etc/letsencrypt/live/ 下的证书确实是新的,签发时间就是十几天前。
续期成功和线上在用,是两回事。这就是这次故障的全部核心。
症状与排查
当时的现场信息:
- ACME 客户端日志显示续期成功,新证书文件时间戳正常。
openssl x509 -in fullchain.pem -noout -dates查看本地文件,有效期是新的。- 但
echo | openssl s_client -connect example.com:443 -servername example.com 2>/dev/null | openssl x509 -noout -dates从外部探测,返回的还是旧证书的日期。
本地文件是新的,TLS 握手给的是旧的。这一步对比基本就把范围锁死了:证书落盘了,但提供 TLS 服务的进程没有加载它。
接着看 nginx。nginx -s reload 的上次执行时间远远早于续期时间。续期脚本里的 deploy hook 没有触发——原因是之前有人改续期配置时,把 --deploy-hook 参数弄丢了,而系统里的 cron 任务只是"续期",续完之后没人通知 nginx。nginx 把证书读进内存之后不会自己盯着文件变化,你不 reload,它就一直用旧的,稳如老狗,稳到过期。
执行了一次 nginx -t && nginx -s reload,外部探测立刻返回新证书日期,告警消除。
根因
直接原因:deploy hook 丢失,续期后没有 reload nginx。
值得多写两句的是为什么会丢。这类故障很少是某人"删了一行配置"这么简单,更常见的过程是:迁移续期方式(比如从 certbot 的 nginx 插件换成 webroot)、换机器、或者把配置从一台老服务器抄到新服务器时,只抄了"能跑起来"的部分。续期本身照样成功,所以问题潜伏着,直到旧证书到期才暴露。这也是证书类故障讨厌的地方:系统坏着的时候,一切看起来都是好的。
预防措施
复盘后落地的几条,按性价比排序:
- 监控要探测线上实际握手的证书,而不是本地文件。 用
s_client或现成的黑盒探测(blackbox exporter 之类)从外部检查notAfter,剩余天数低于续期周期就该告警。只监控文件时间的监控,这次就等于没监控。 - 续期流程必须包含部署动作,并且把"续期+reload"当成一个整体去测试。 测试方法不是跑一遍续期,而是用
--dry-run配合强制 deploy hook 执行,确认 hook 真的会跑。更狠一点的做法:把测试证书的到期时间调近,走一遍完整链路。 - reload 之前先
nginx -t。 这次没踩到,但常见剧情是 hook 里直接 reload,而某处配置有语法错误,reload 失败没人知道。hook 脚本里失败要非零退出、要有人能看到。 - 部署动作最好有记录。 什么时候续的、什么时候 reload 的、reload 成没成功,出了问题不用靠翻 shell 历史考古。
在 CertbotX 中实践
"续期成功但部署缺失"正是把签发和部署拆开手工维护时最容易断的环节。在 CertbotX 里,DNS-01 验证(支持 CNAME 委托,域名不用直接挂在 ACME 账户下)完成签发后,可以把证书自动部署到 Agent、EdgeOne 或 CDN,到期前自动重新签发并再次部署,不需要自己维护 hook 脚本。每次部署都有记录可查,复盘时不用猜"上次到底有没有 reload"。这并不能替代上面第 1 条——外部探测该做还是要做,任何自动化都值得被监控盯着。
小结
这次故障从告警到恢复不到半小时,但它暴露的盲区很典型:大家盯着"续期"这个环节投入了大量自动化,却默认"部署"会自己发生。TLS 链路上,签发、分发、加载是三个独立步骤,任何一步没有闭环,前面的努力都只是磁盘上的几个新文件。