证书续期失败为什么总是在深夜才被发现
分析 ACME 自动续期链路中常见的失败点——HTTP-01 被重定向拦截、DNS-01 凭证过期、部署环节断链——以及续期成功后私钥长期不换带来的风险,给出监控和处置思路。
本文目录
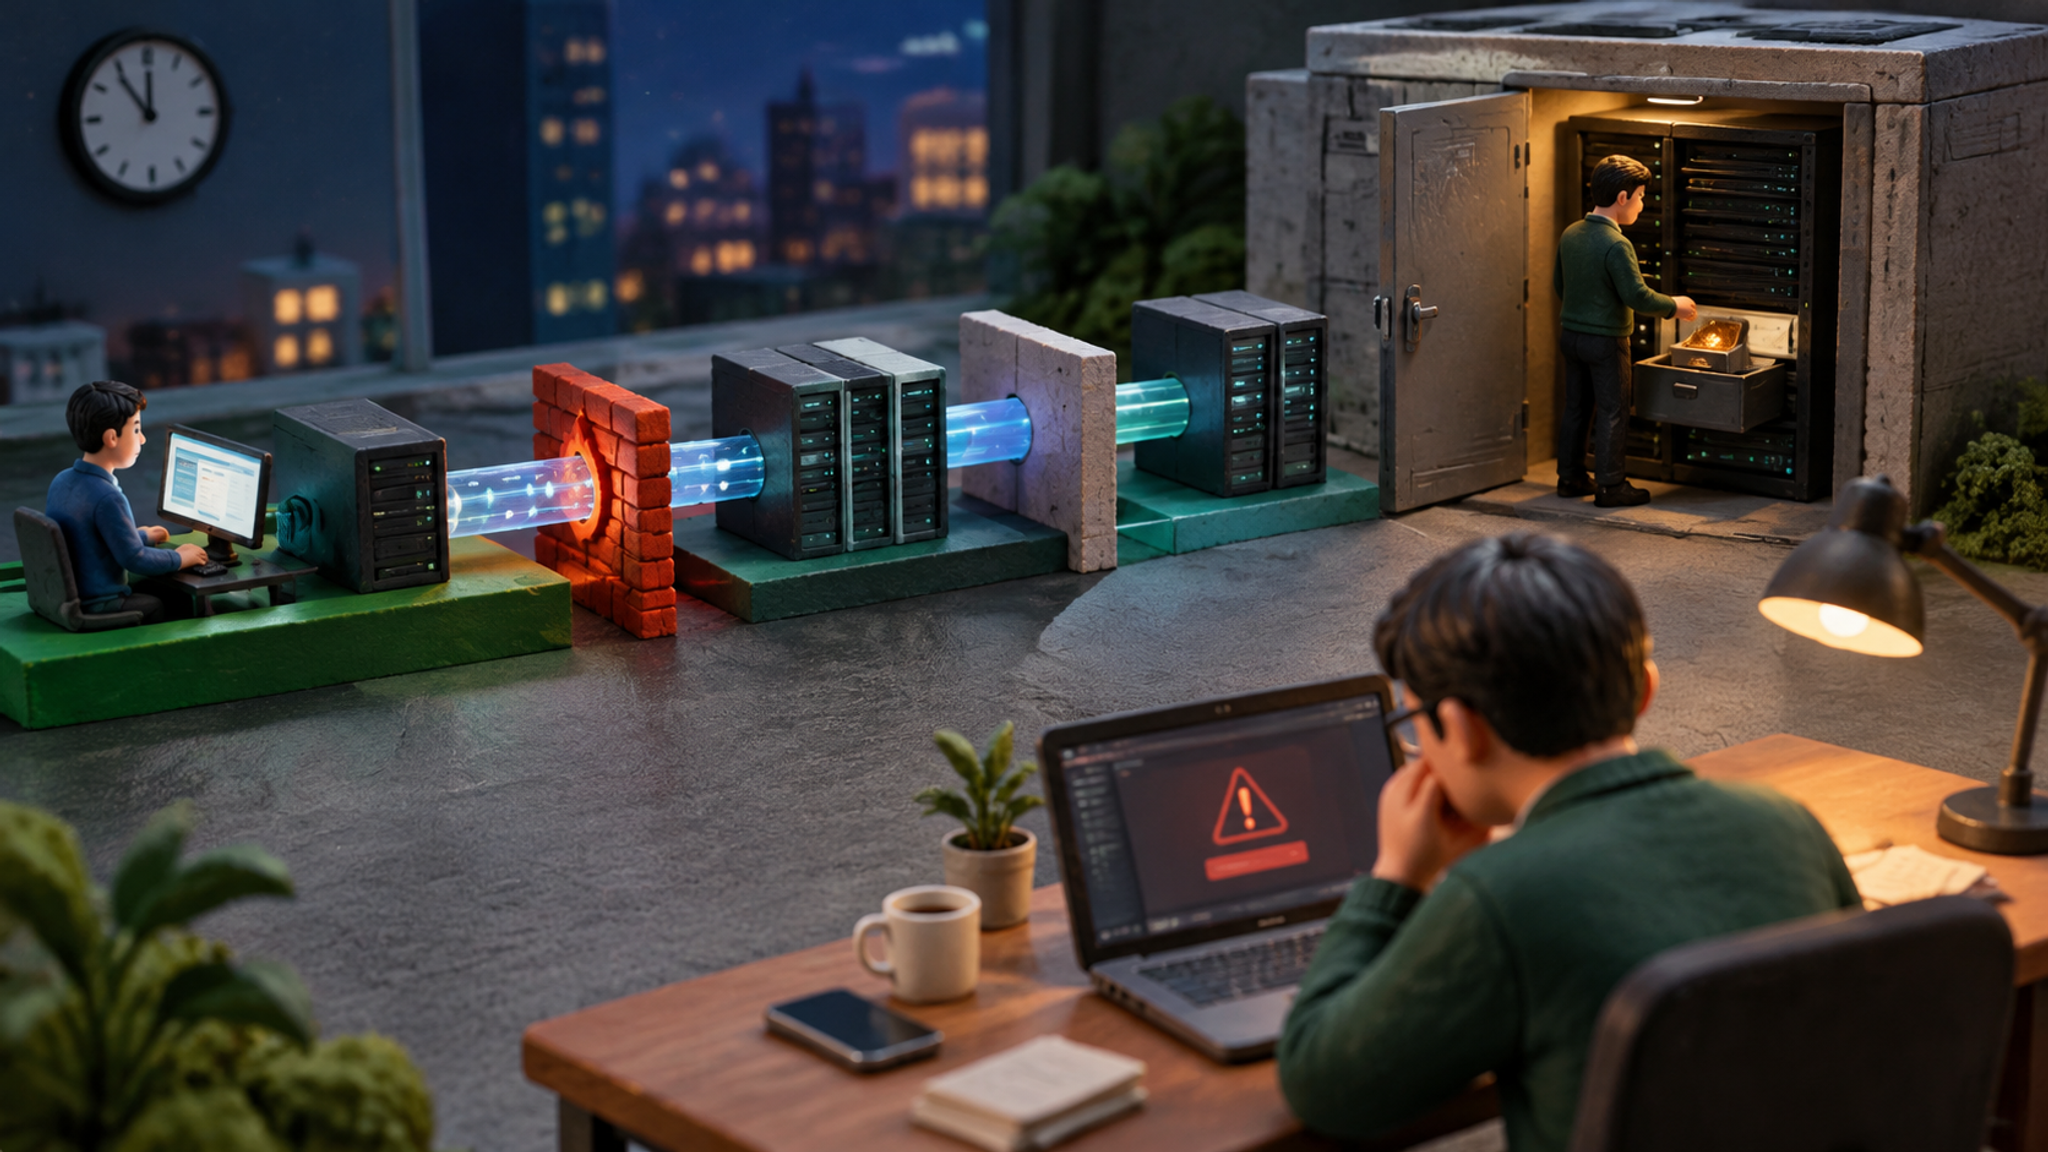
很多团队的 TLS 事故报告长得像同一份模板:凌晨告警,证书过期,运维登录后发现 ACME 客户端三个月前就停止续期了,期间没人注意。问题很少出在 ACME 协议本身,而是出在续期链路里那些被默认"不会变"的环节。
续期失败最常见的三个断点
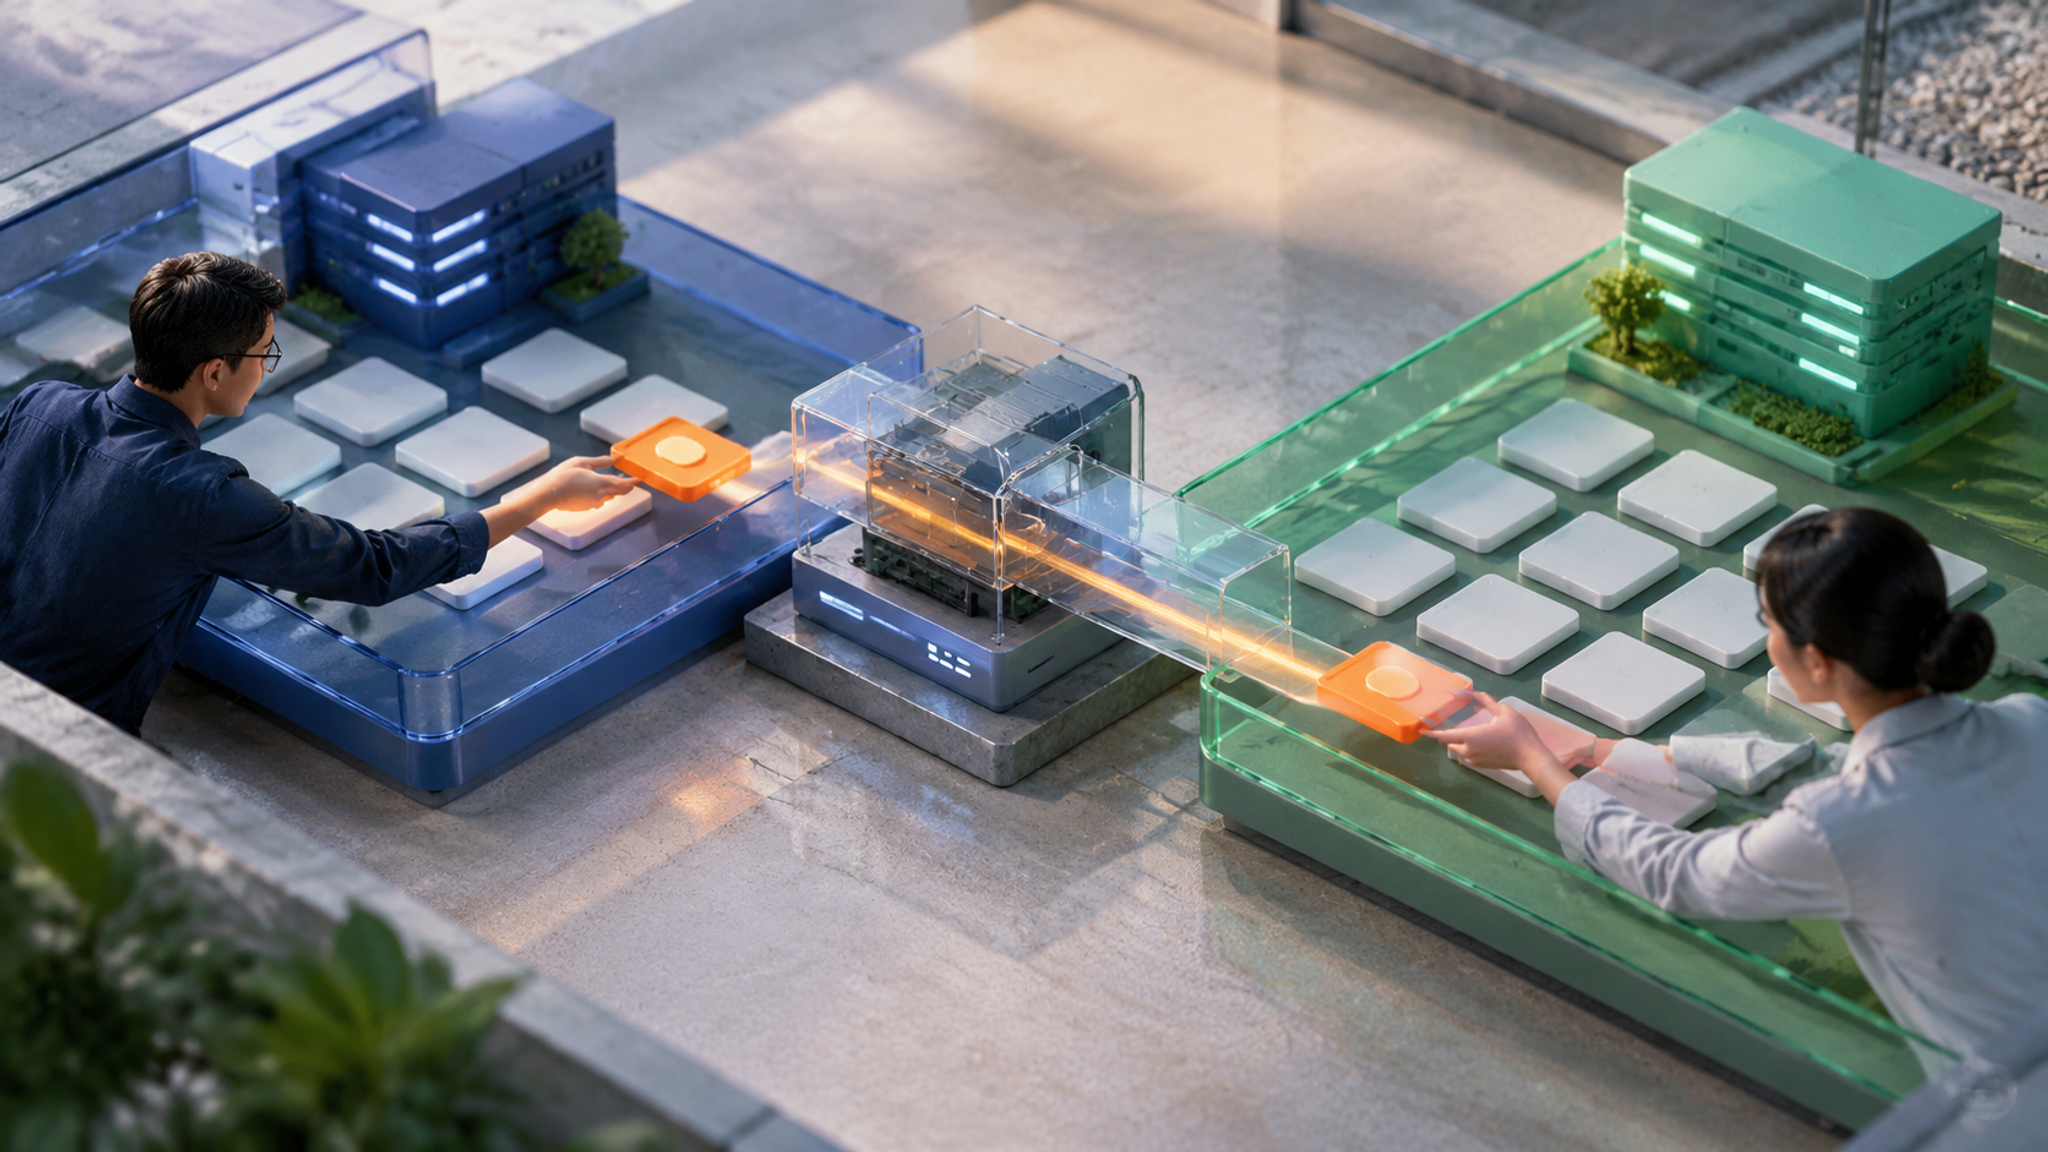
HTTP-01 验证被自己的重定向挡住。 不少人配 Nginx 时写了全站 301 到 HTTPS,或者后来加了 CDN/WAF 规则,把 /.well-known/acme-challenge/ 也一并转发或拦截了。证书有效期九十天,改动发生在第六十天,之后每次续期都静默失败,直到证书到期那天才有人发现。这是最常见也最冤的一种。
DNS-01 的 API 凭证失效。 DNS-01 需要能写 TXT 记录的凭证。凭证轮换、子账号权限收紧、DNS 服务商 API 变更,任何一个都会让续期悄悄挂掉。和 HTTP-01 不同,DNS-01 失败时网站访问完全正常,没有任何外部信号。
签出来了,但没部署。 有些脚本只负责签发,证书躺在 /etc/letsencrypt/live/ 里很新,Nginx 却因为没 reload 还在用旧证书;或者证书要推到 LB、CDN、边缘节点,推送脚本挂了。检查服务器本地文件一切正常,用户看到的却是过期证书——这种分裂状态排查起来格外耗时间。
别只监控"还有几天到期"
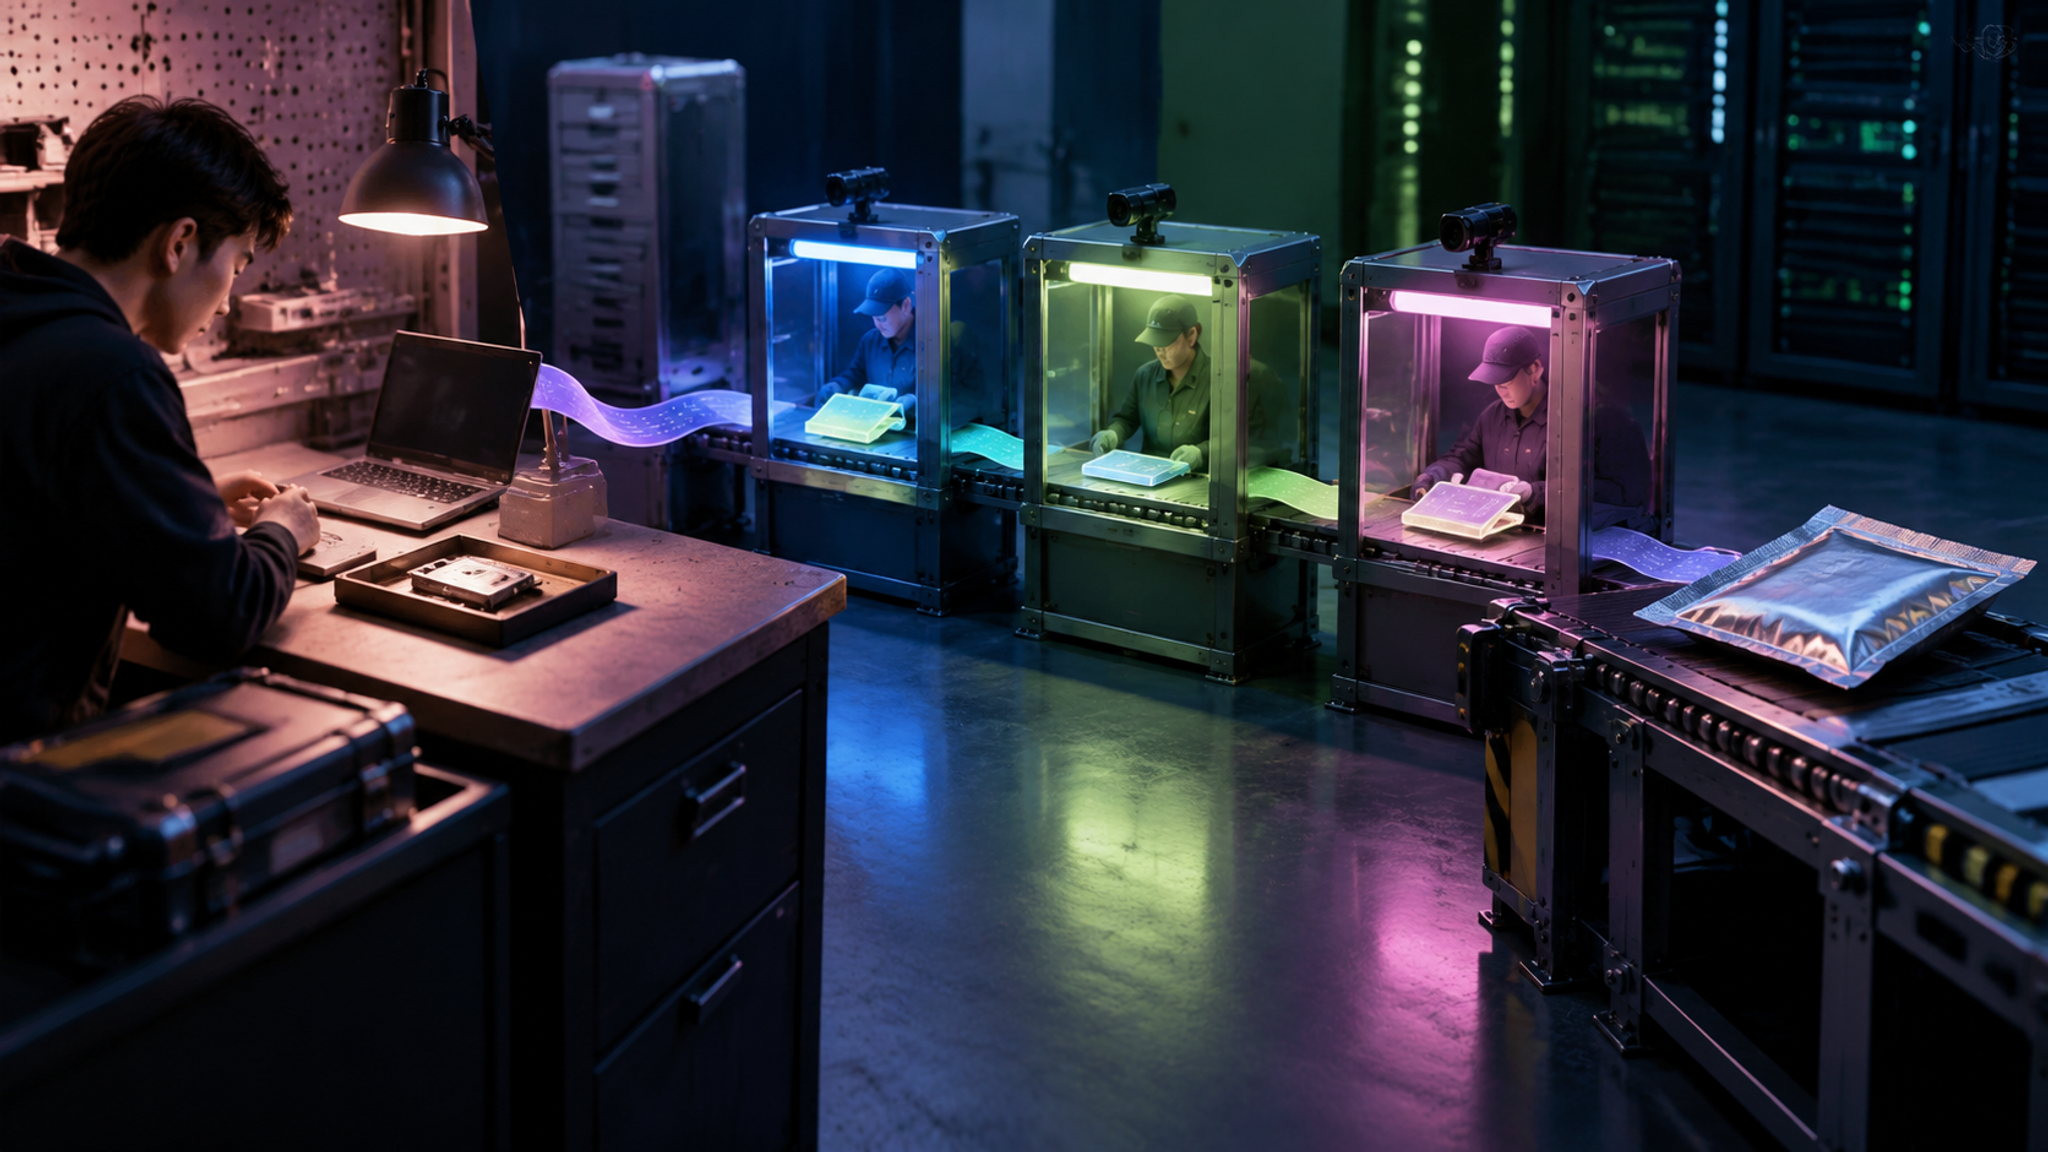
在证书文件上跑 openssl x509 -enddate 只能告诉你本地这份证书的状态。更靠谱的做法是从外部探测实际对外服务的证书链:用监控探针定期做 TLS 握手,读取对端返回的证书有效期和指纹。外部视角能同时抓住两类问题:续期失败(有效期逼近)和部署断链(外部看到的指纹和本地新证书对不上)。
另外,ACME 客户端的失败日志要接进告警,而不是只在 systemd journal 里积灰。续期失败时距离到期通常还有一两个月,这是最宽裕的处置窗口,浪费了可惜。
在 CertbotX 中实践
CertbotX 用 DNS-01 完成 ACME 自动签发,支持把验证用的 TXT 记录通过 CNAME 委托到独立区域,这样主域名的 DNS 凭证不用给到签发流程,凭证面能收得很窄。证书在到期前自动重新签发,签出后直接推送到 Agent、EdgeOne 或 CDN,避免"签了新证书但服务还在用旧的"这种断链。每次签发和部署都有记录可查,出问题时能直接从审计记录定位是哪一环没走通,而不是去翻各个节点的 journal。
私钥:续期时顺手换掉
一个容易被忽略的取舍:很多 ACME 客户端默认续期时复用私钥,方便是方便,但私钥的暴露窗口会无限拉长。如果私钥在某个时间点泄露过而你不知道,攻击者手里这把钥匙就一直有效,直到你主动换。Let’s Encrypt 的证书最长九十天,私钥轮换的成本几乎为零——签发新证书时生成新密钥对即可,旧的随旧证书一起作废。
代价只有一个:如果你做了证书固定(HPKP 之类,现在基本没人该用了)或者依赖固定公钥的 pinning 逻辑,轮换私钥会打破它。对绝大多数只跑标准 TLS 的服务,续期即换钥是更稳的默认姿势。顺便确认私钥文件权限是 0600 且属 root,这件事说了很多年,巡检时还是经常能捡到 0644 的惊喜。
出事时的处置顺序
如果怀疑私钥泄露,顺序是:先在测试路径上签发新密钥对的新证书并部署,确认服务正常,再吊销旧证书。反过来先吊销再换,等于给自己制造一段不可用窗口。吊销走 ACME 协议的标准流程,RFC 8555 里定义得很清楚;注意吊销是让遵守规范的客户端拒绝这张证书,不是魔法删除——私钥本身已经在外的话,新密钥对才是真正的止血手段。
最后一点:把证书到期当成和磁盘水位一样的常规监控项,而不是"自动化会处理"的心理安慰。自动化的价值在于平时不出声,出声的时候一定要有人听见。