证书没过期,为什么半夜还是被用户投诉打不开——聊聊证书生命周期里那些监控覆盖不到的坑
证书生命周期的事故大多不是"忘了续期",而是续了但旧证书还在某个节点上、链不完整、或多套签发渠道互相覆盖。本文梳理这些监控盲区,并说明自动化签发与部署审计如何把问题收敛到可控范围。
本文目录
凌晨三点,告警群里没动静,客服群里先炸了:某省份用户打开站点提示证书错误。运维第一反应是查到期时间——证书还有四十天,监控面板一片绿。查了一圈才发现,CDN 边缘节点上挂的还是上一张证书,而那张确实已经过期了。
这类事故的共同点在于:证书本体没问题,是证书"所过之处"出了问题。 监控到期时间只覆盖了证书生命周期的一个端点,而真正的风险往往藏在中间环节。
续期成功 ≠ 部署成功
最常见的误会:脚本里 certbot renew 返回 0,就默认全站安全了。实际上续期只完成了签发这一步,证书文件落到本地磁盘后,还要经过一条链:
- Web 服务器(Nginx/Apache)是否加载了新证书——很多配置需要 reload 才生效,进程里驻留的还是旧证书;
- 负载均衡、CDN、WAF 这些上游是否也拿到了新证书——它们各自维护一份,互不通知;
- 有没有遗留的旧节点——下线了一半的服务、测试环境对外暴露的端口,常常是"过期证书收容所"。
所以监控的颗粒度应该是"每个对外端点实际呈现的证书",而不是"磁盘上证书文件的时间戳"。用探测脚本定期对真实域名做 TLS 握手,读取对端返回的证书,才能发现"文件是新的、线上是旧的"这类错位。
链不完整:移动端的第一批受害者
另一个高频坑是中间证书缺失。桌面浏览器大多会用 AIA fetching 自动补齐缺失的中间证书,所以本地测试一切正常;但很多 Android 老版本和部分 API 客户端不做这一步,直接握手失败。
后果就是故障报告呈诡异的分布:老板手机上没问题,用户投诉却不断。签发后务必检查完整链——服务器应该把叶子证书加上中间证书一起发送(fullchain),只发叶子是一种"看运气"的部署。运气这东西,通常在最不想赌的时候输掉。
多签发渠道互相覆盖
团队大了以后,经常出现证书来源不止一处:运维用 ACME 客户端续,平台组在云控制台点了一键申请,CDN 上又托管了另一张。三套证书来回覆盖,有时新续的被旧的顶掉,故障表现为"证书随机过期"。
处置思路不复杂,但需要纪律:
- 每个域名只保留一个权威签发渠道,其他的关掉或明确降级为备份;
- 部署动作要有记录可查——什么时候、谁、把哪张证书推到了哪里,出问题时才能快速定位是哪一环覆盖的;
- 证书指纹(公钥哈希)比"到期时间"更适合做一致性校验,因为它能识别"换了一张同样没过期的证书"这种隐蔽变化。
自动化要覆盖"最后一公里"
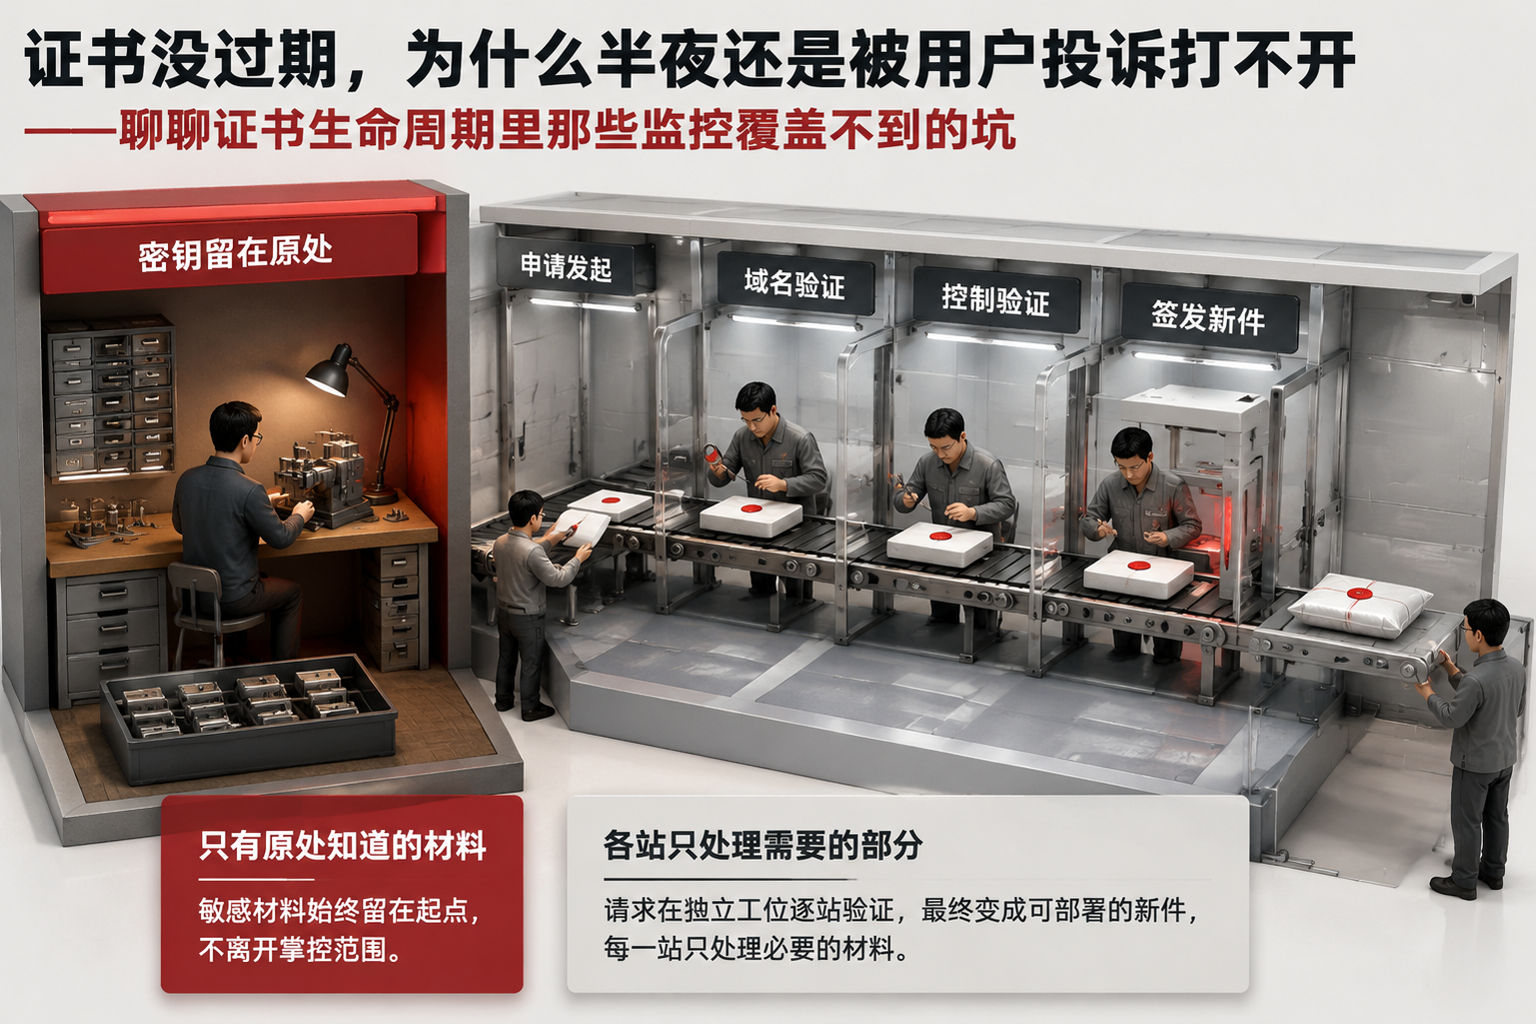
单纯把签发自动化,只解决了生命周期的前半段。真正省心的做法是把续期、部署、验证、留痕串成一条流水线,且验证环节必须做真实握手探测,而不是检查文件是否更新。
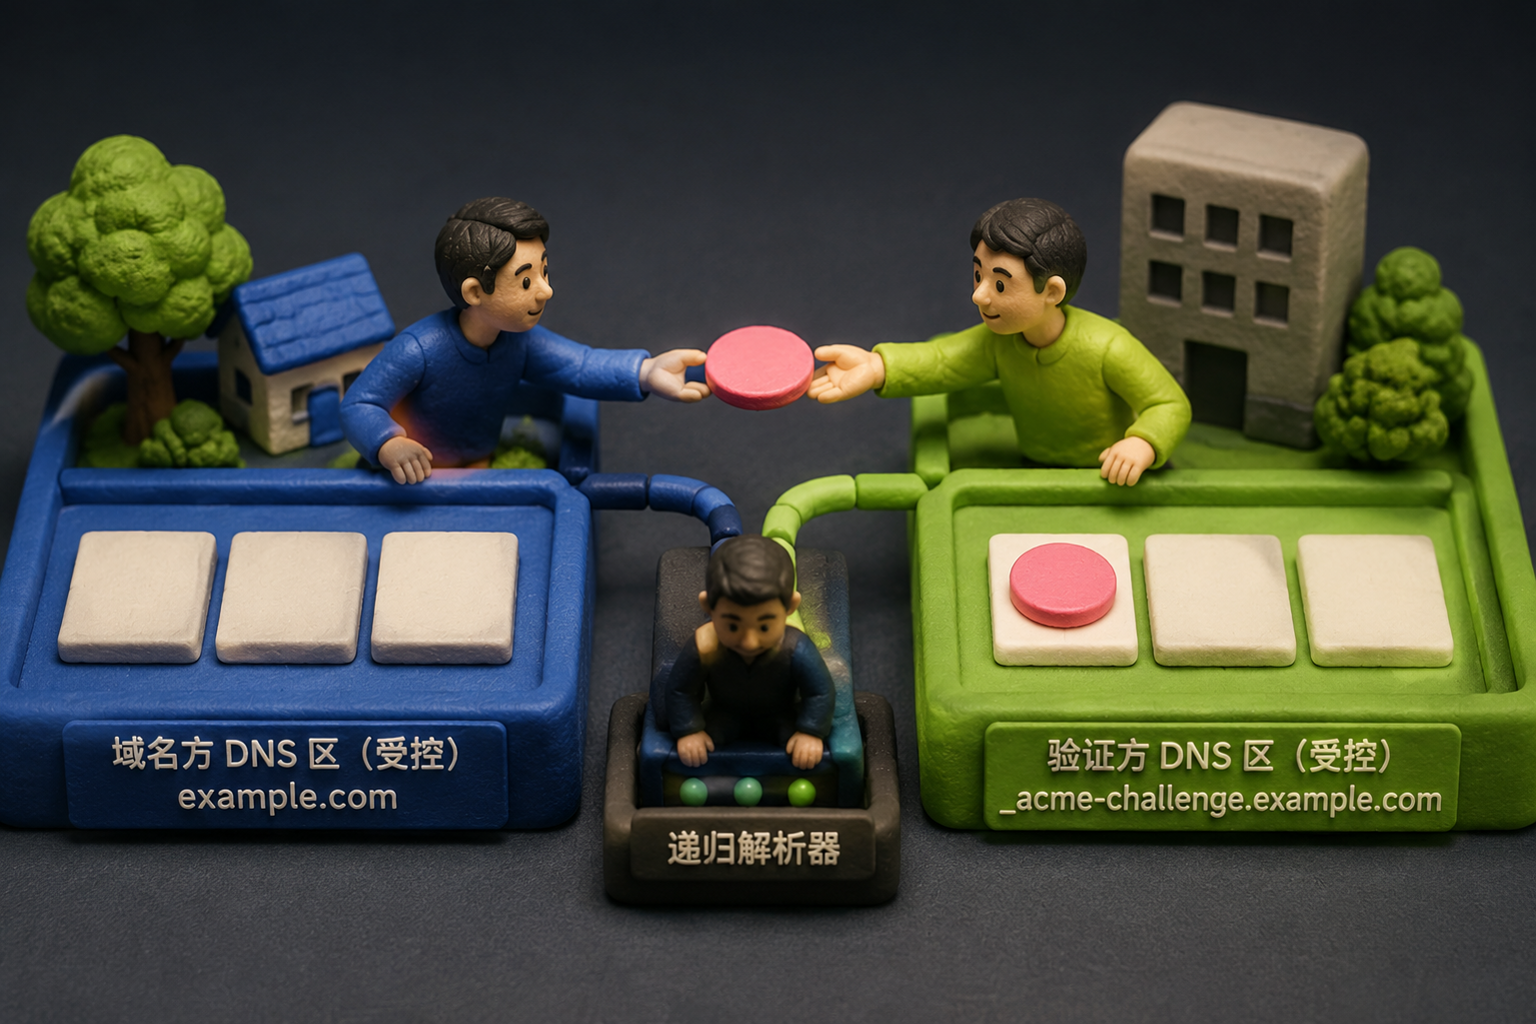
在 CertbotX 中实践:针对 DNS 解析不在手边或需要通配符的场景,可以用 DNS-01 加 CNAME 委托完成域名验证,由 ACME 自动签发并在到期前重新签发;签发后证书会自动推送到 Agent、EdgeOne 或 CDN 这类目标,避免"新证书躺在磁盘上没人装"的经典事故;每次部署都会留下记录,便于审计和在多渠道覆盖时快速追查是谁动了哪张证书。
收尾时的取舍
如果团队规模不大,不必一上来就建完整的证书资产台账。优先级建议是:先保证每个对外域名有真实的握手探测监控(覆盖 CDN 回源和边缘),再统一签发渠道,最后补齐部署审计。这三步做完,凌晨三点的客服群大概会安静不少——至少不会因为一张"明明没过期"的证书再响起来。
延伸阅读: